
Guía práctica
Falta robots.txt: ¿es un problema para Google?
La ausencia de robots.txt no impide por sí misma que Google rastree o indexe tus páginas públicas. Un 404 normalmente indica que ese archivo no establece restricciones. Revisa la respuesta y las reglas que necesitas antes de cambiar tu sitio.
Qlinnt · Revisado
El rastreo y la indexación son decisiones distintas
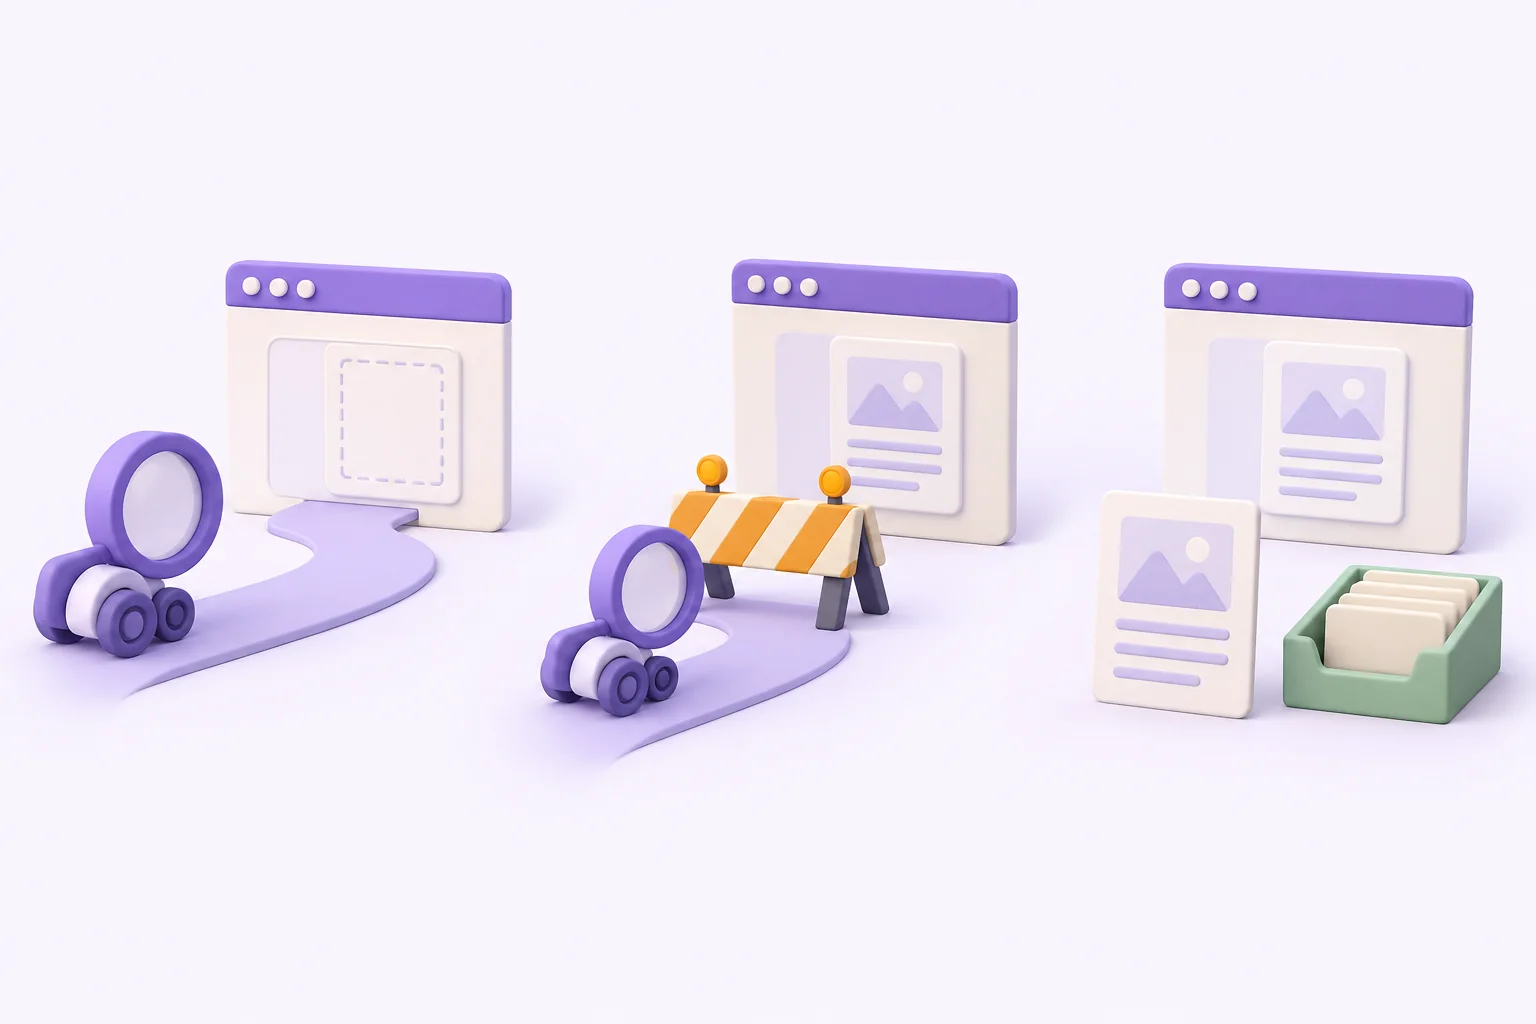
- robots.txt ausente
GET /robots.txt → 404Normalmente significa que no hay restricciones de rastreo en ese archivo. Por sí solo, no impide la indexación.
- Rastreo bloqueado
User-agent: *
Disallow: /
Pide a los rastreadores que respetan estas reglas que no accedan al sitio. Es una regla de rastreo, no una instrucción para retirar las URL del índice.
- Indexación excluida
noindexUna vez que un rastreador compatible accede y procesa la directiva, la página debería quedar fuera de su índice. No pongas noindex en robots.txt.
Bloquear el rastreo no elimina de forma fiable una URL ya indexada. El rastreador debe poder acceder a la página para leer su directiva noindex.
Comprueba la respuesta antes de cambiar el sitio
Consulta /robots.txt en el origen exacto de producción, con HTTPS y el hostname correcto. Un archivo en www.example.com no define las reglas de otro host. Una respuesta 200 debe contener reglas de texto, no una pantalla de acceso ni el HTML de la aplicación.
Inspecciona solo un sitio propio o autorizado. Esta consulta lee una respuesta pública; no reproduce una visita de Googlebot verificado.
curl -i https://example.com/robots.txtDecide si existe un problema
La ausencia del archivo, las restricciones intencionales y los fallos del servidor requieren acciones diferentes. No retires protecciones solo para obtener un resultado aprobado.
| Qué observas | Qué comprobar | Siguiente paso |
|---|---|---|
| 404 o 410 | No existe robots.txt en este origen. | No es obligatorio para permitir el rastreo. Agrégalo si necesitas reglas o una referencia al sitemap. |
| 200 con reglas de texto | Revisa el grupo de user-agent y las rutas Allow/Disallow. | Conserva las reglas intencionales. Investiga bloqueos accidentales de páginas públicas. |
| 200 con HTML | El servidor puede estar entregando la aplicación en lugar del archivo. | Publica una respuesta de texto en /robots.txt y compruébala después del despliegue. |
| 429 o 5xx | Los límites o la disponibilidad pueden impedir la consulta. | Investiga los registros y la disponibilidad. No equivale a un archivo ausente normal. |
En un sitio estático, publica un archivo de texto
Si necesitas el archivo, colócalo en la raíz pública del despliegue. Sustituye el origen del sitemap. Este ejemplo sin restricciones sirve cuando quieres permitir el rastreo del sitio.
Disallow no es autenticación. Protege las páginas sensibles con controles de acceso. Para excluir de búsquedas una página accesible, utiliza noindex y permite que el robot lea la directiva.
User-agent: *
Allow: /

Sitemap: https://example.com/sitemap.xml
En Next.js App Router, genera el archivo
Crea app/robots.ts o src/app/robots.ts si el proyecto usa src. Usa el dominio de producción, sin localhost ni URLs de preview. Publica esta ruta una sola vez; evita otro robots.txt estático que entre en conflicto.
import type { MetadataRoute } from 'next';

export default function robots(): MetadataRoute.Robots {
  return {
    rules: { userAgent: '*', allow: '/' },
    sitemap: 'https://example.com/sitemap.xml',
  };
}
Verifica el resultado desplegado
Repite la consulta después del despliegue y revisa estado, cuerpo y hostname. Inspecciona luego una URL pública importante en Search Console. Poder leer robots.txt no demuestra indexación ni posición.
- La respuesta publicada contiene el texto previsto, sin preview ni HTML de la aplicación.
- Las páginas públicas no incluyen noindex accidental.
- El sitemap enumera las URLs canónicas públicas previstas.
- La autenticación y los informes excluidos intencionalmente conservan sus protecciones.
Qué puede confirmar Qlinnt y qué no
Qlinnt consulta las respuestas públicas de robots y sitemap junto con otras señales técnicas. Su control automático de robots no es un simulador completo de reglas por user-agent. Usa los informes de Google y los registros del servidor para investigar casos específicos de rastreo.
Si un builder con IA dice que cambió el archivo, verifica la URL desplegada en lugar de confiar solo en el chat. Ejecuta un escaneo nuevo para revisar de nuevo las señales públicas.
Fuentes
Escanea tu sitio público
Empieza con un escaneo gratuito. Verifica tu email para leer todos los hallazgos explicados. La evidencia completa y los prompts adaptados requieren acceso completo; las compras nuevas están pausadas.
Escanear gratis